009 — Prometheus & Grafana Metrics Cheatsheet
Dựng dashboard Grafana hoành tráng nhưng khi sự cố xảy ra lại không biết nhìn vào đâu? Viết query PromQL sai cú pháp khiến dashboard tải chậm hoặc alert bắn loạn xạ giữa đêm?
009 — Prometheus & Grafana Metrics Cheatsheet
Caption
Dựng dashboard Grafana hoành tráng nhưng khi sự cố xảy ra lại không biết nhìn vào đâu? Viết query PromQL sai cú pháp khiến dashboard tải chậm hoặc alert bắn loạn xạ giữa đêm?
Lưu ngay bảng tra cứu 4 Golden Signals (Google SRE) và các câu lệnh PromQL chuẩn chỉnh dưới đây để tối ưu hệ thống monitoring:
-
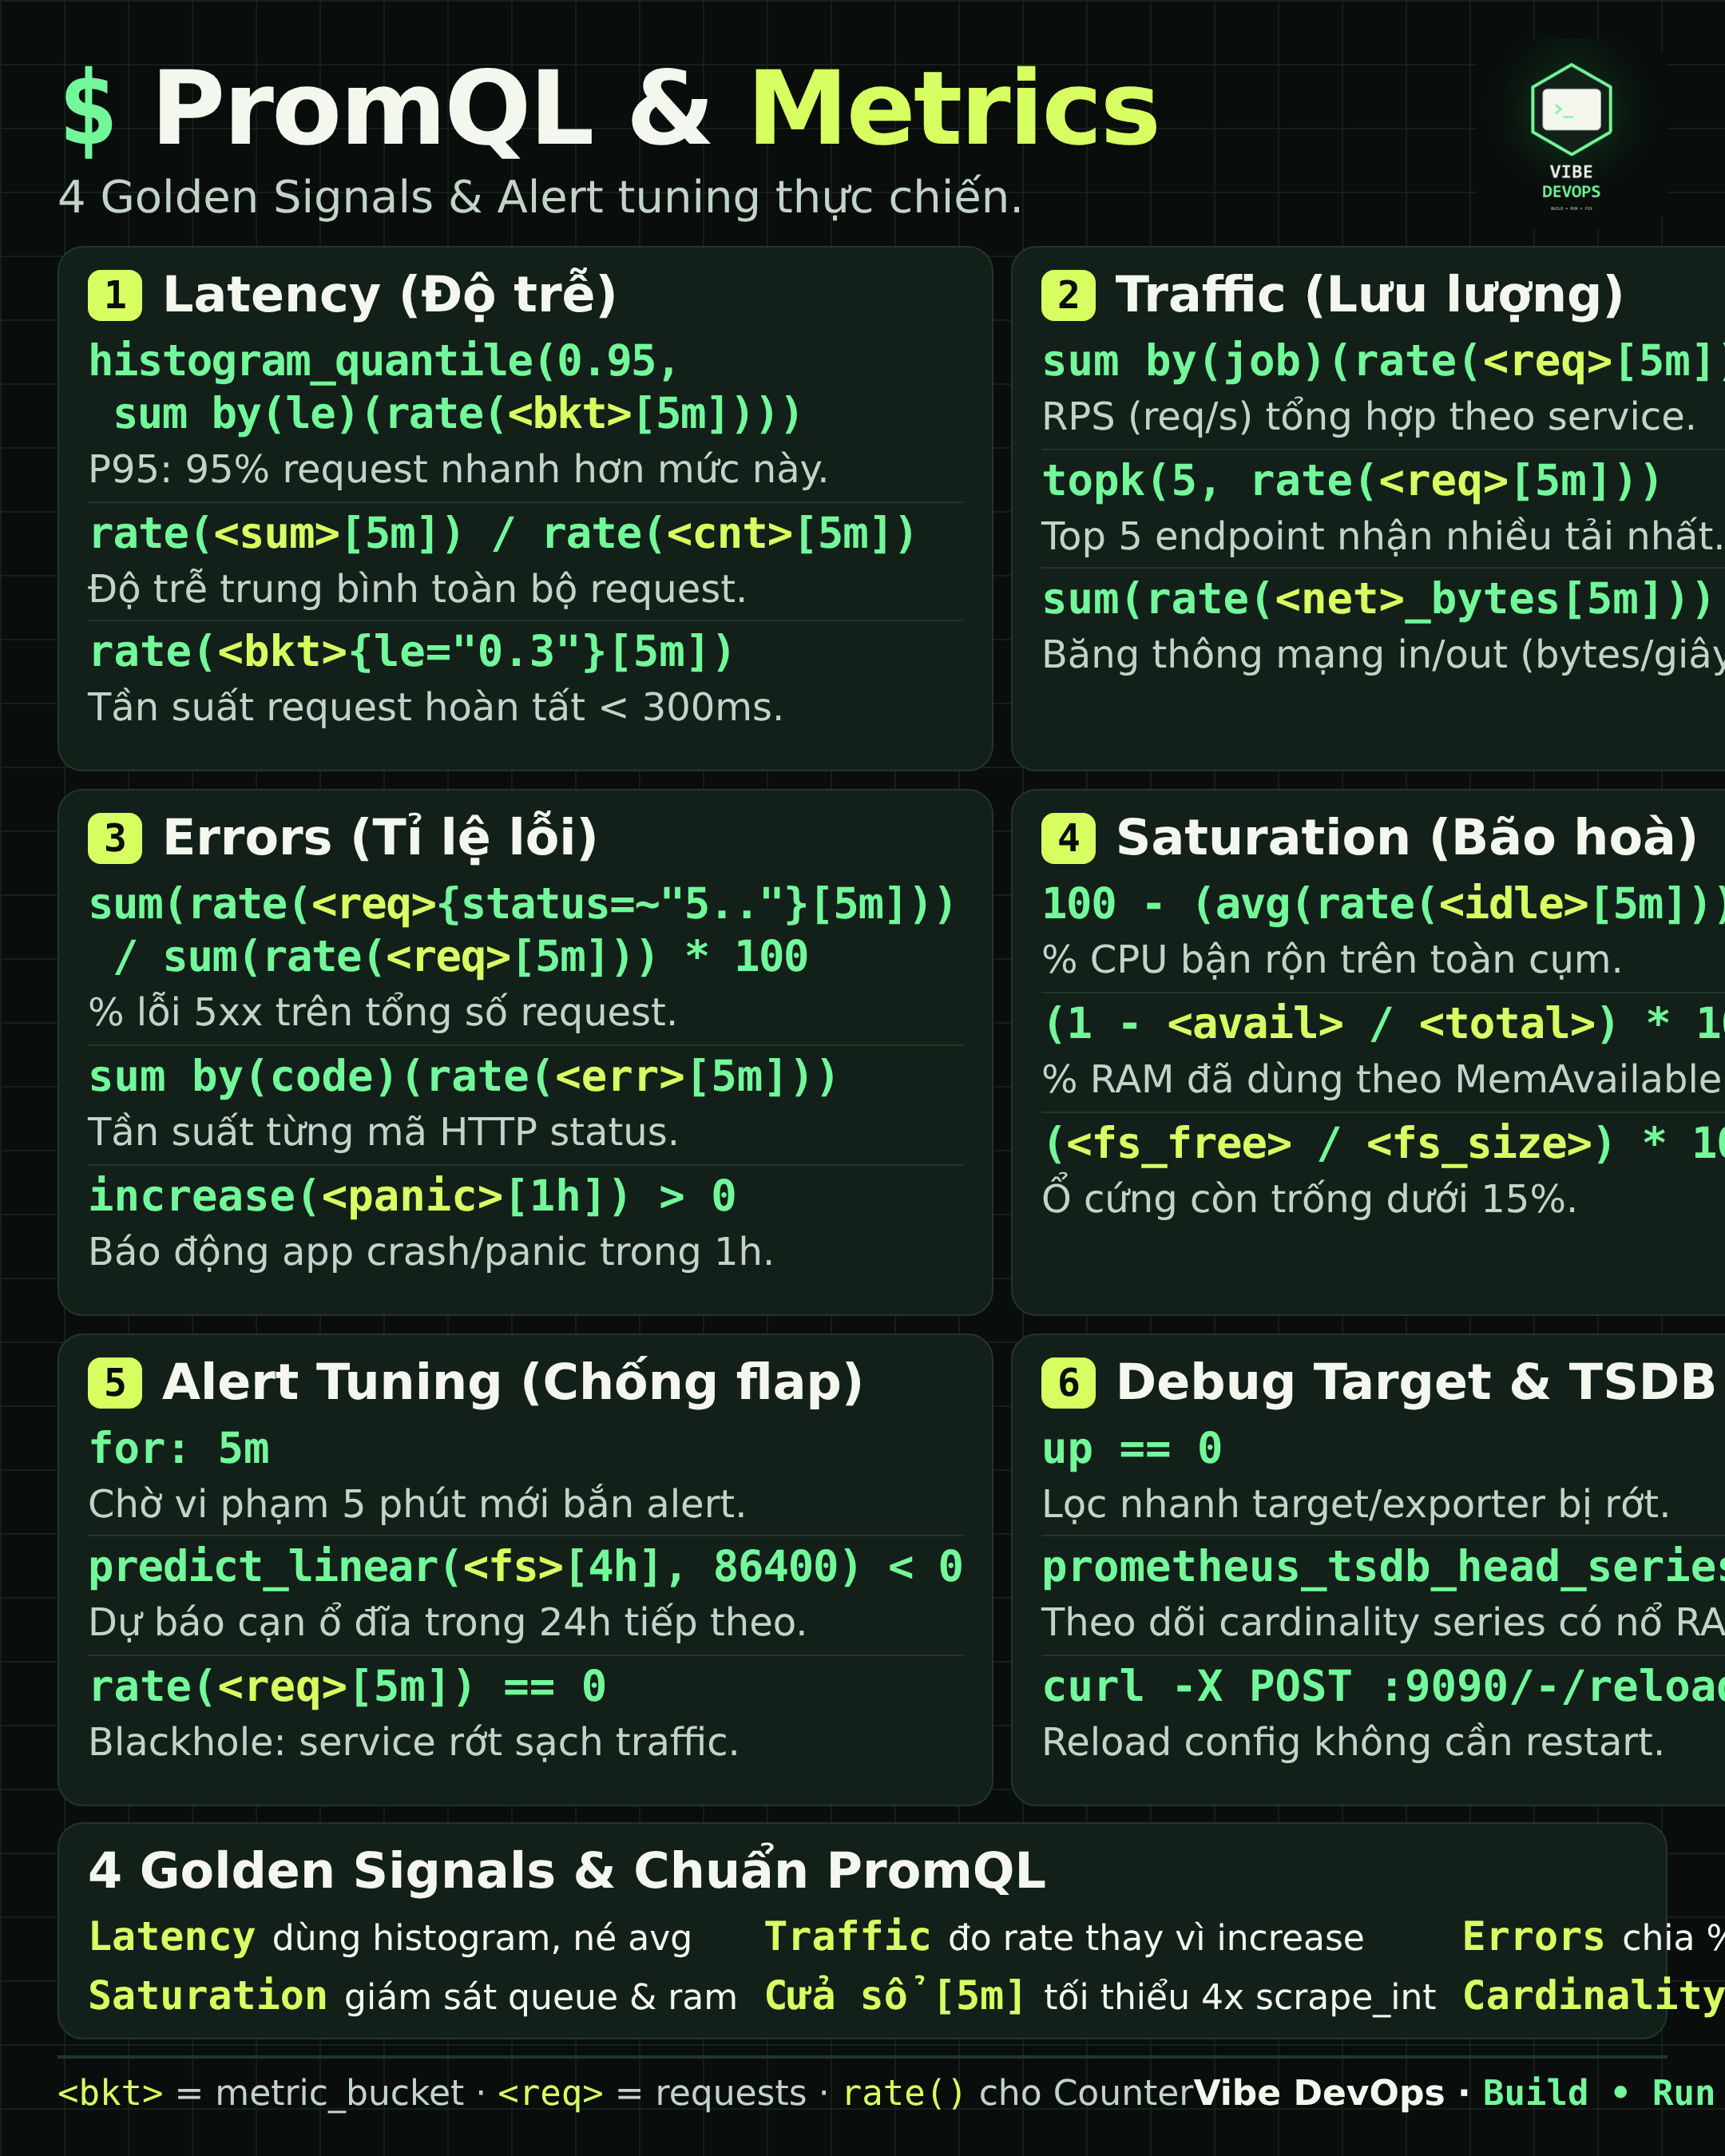
Latency (Độ trễ) — Tuyệt đối không dùng trung bình cộng (avg) vì sẽ che giấu các request bị nghẽn cục bộ. Dùng histogram_quantile(0.95, sum by(le)(rate(
[5m]))) để theo dõi P95 (95% request nhanh hơn mức này). Muốn tính độ trễ trung bình toàn bộ, chia rate(sum) cho rate(count). -
Traffic (Lưu lượng) — Đo lường nhu cầu thực tế trên hệ thống. sum by(job)(rate(
[5m])) cho bạn tổng RPS (requests per second) gom nhóm theo từng microservice. Dùng topk(5, rate(...)) để tóm nhanh top 5 API endpoint đang chịu tải nặng nhất. -
Errors (Tỉ lệ lỗi) — Đo lường tỉ lệ thất bại. Tính % lỗi 5xx trên tổng số request bằng cách chia rate status 5xx cho rate toàn bộ request rồi nhân 100. Giám sát tăng đột biến panic/crash bằng increase(
[1h]) > 0 để bắt bệnh trước khi người dùng than phiền. -
Saturation (Bão hoà tài nguyên) — Mức độ đầy của hạ tầng. Tính % CPU bận rộn trên toàn cụm bằng 100 trừ đi % idle. Với RAM trên Linux, luôn dùng node_memory_MemAvailable thay vì MemFree để phản ánh đúng bộ nhớ khả dụng thực tế. Đặt cảnh báo khi dung lượng ổ đĩa còn trống dưới 15%.
-
Alert Tuning (Chống Alert Fatigue) — Alert bắn liên tục gây chai lì thông báo? Luôn dùng tham số for: 5m trong Prometheus alert rule để loại bỏ các đợt giật tạm thời (spike). Dùng hàm predict_linear(
[4h], 86400) < 0 để dự báo ổ cứng sẽ đầy trong 24 giờ tới thay vì chờ đến khi cạn kiệt. -
Debug Target & TSDB — up == 0 để lọc nhanh exporter hay service nào vừa mất nhịp tim. prometheus_tsdb_head_series giúp kiểm tra số lượng time-series trong RAM để phát hiện nguy cơ nổ cardinality do gắn tag linh tinh (như user_id hoặc query params vào metric label). Nạp lại config tức thì bằng curl -X POST :9090/-/reload.
Mẹo vàng từ Google SRE:
• Latency: Luôn dùng Histogram với histogram_quantile, né hàm avg.
• Traffic: Dùng rate() cho metric dạng Counter, không dùng increase() để đo tải.
• Window [5m]: Cửa sổ thời gian tối thiểu phải gấp 4 lần scrape interval (15s x 4 = 1m, an toàn nhất là 2m-5m).
• Cardinality: Tuyệt đối không đưa UUID, Email, UserID vào label của Prometheus metric.
Đội ngũ của bạn đang dùng Prometheus & Grafana để monitor những chỉ số nào quan trọng nhất? Chia sẻ kinh nghiệm ở phần bình luận nhé!
VibeDevOps #Prometheus #Grafana #PromQL #DevOps #SRE #Monitoring #Observability #CloudNative #Kubernetes #DevOpsVietnam
💡 Mẹo lưu trữ & sử dụng trong đội ngũ
Bạn có thể tải bản PDF vector về lưu trữ trong kho tài liệu nội bộ của team (Notion, Confluence) hoặc in khổ A4 dán tại bàn làm việc để tra cứu nhanh khi gặp sự cố lúc nửa đêm.